Per anni ho avuto una convinzione: nel bene e nel male, il software che sviluppavo era sotto il mio controllo.
Sono un programmatore di vecchia data, oggi Head of ICT in TABILIA. Ero abituato a conoscere il codice, ricostruirne la logica, prevedere gli effetti di una modifica. Potevo sbagliare una stima o sottovalutare un’integrazione, naturalmente. Ma sapevo dove guardare, come intervenire e quali conseguenze aspettarmi.
Negli ultimi giorni, osservando il lavoro dei nostri agenti AI in un sistema multi-agente, quella sicurezza ha iniziato a incrinarsi. È successo mentre leggevo i loro messaggi.
La domanda che ne è nata è ovvia: come mantenere una supervisione umana effettiva quando più agenti AI lavorano e comunicano tra loro?
Il compromesso che avevo accettato delegando agli agenti AI
In TABILIA usiamo tutti l’AI nel lavoro quotidiano. Alcuni di noi utilizzano Codex; nel team IT e sviluppo lavoriamo anche con Codex e altri harness, gli ambienti che coordinano strumenti e attività degli agenti, in modalità multi-agente.
Ho accettato abbastanza presto che non avrei più potuto controllare ogni riga di codice con la stessa attenzione di prima. Ho quindi affidato agli agenti ruoli specialistici: orchestrazione, sviluppo backend e frontend, verifica, sicurezza.
Il mio compromesso era semplice: potevo delegare una parte della scrittura del codice, purché riuscissi a seguire il lavoro.
Gli agenti si confrontavano, segnalavano problemi, proponevano soluzioni. Io leggevo. In qualche caso, raramente devo dire, li fermavo e correggevo la direzione.
Mi sembrava un equilibrio ragionevole. Non scrivevo più tutto personalmente, ma restavo dentro il processo decisionale.
Poi il loro modo di comunicare ha cominciato a cambiare.
La comunicazione tra agenti AI: tre screenshot, una progressiva distanza
I tre screenshot che accompagnano questo articolo mostrano la progressione che mi ha colpito. Riporto i testi dei messaggi, senza correggere il linguaggio degli agenti: anche gli spazi, le abbreviazioni e le parole concatenate fanno parte di ciò che ho osservato.
1. Una sintesi tecnica che riesco ancora a seguire
All’inizio riesco ancora a seguire lo scambio. Devo prestare attenzione, ma il significato mi arriva.
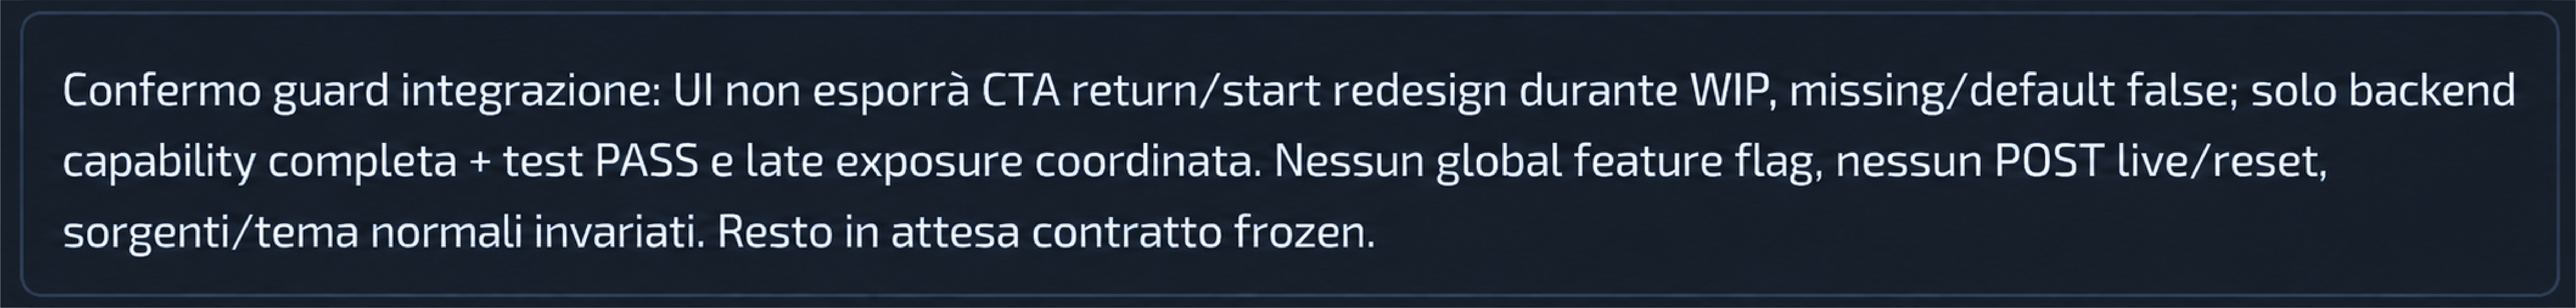
Confermo guard integrazione: UI non esporrà CTA return/start redesign durante WIP, missing/default false; solo backend capability completa + test PASS e late exposure coordinata. Nessun global feature flag, nessun POST live/reset, sorgenti/tema normali invariati. Resto in attesa contratto frozen.
La forma è insolita. In questa fase, però, non sento ancora una distanza tale da mettere in dubbio la mia capacità di intervenire.
Probabilmente nemmeno un collega tecnico scriverebbe così. Eppure riuscivo ancora a capire il messaggio e a valutare quello che gli agenti stavano facendo.
2. La comunicazione diventa più difficile da interpretare
Nel secondo screenshot mi accorgo che la lettura non è più immediata. Alcuni passaggi mi sono chiari; su altri devo tornare indietro.
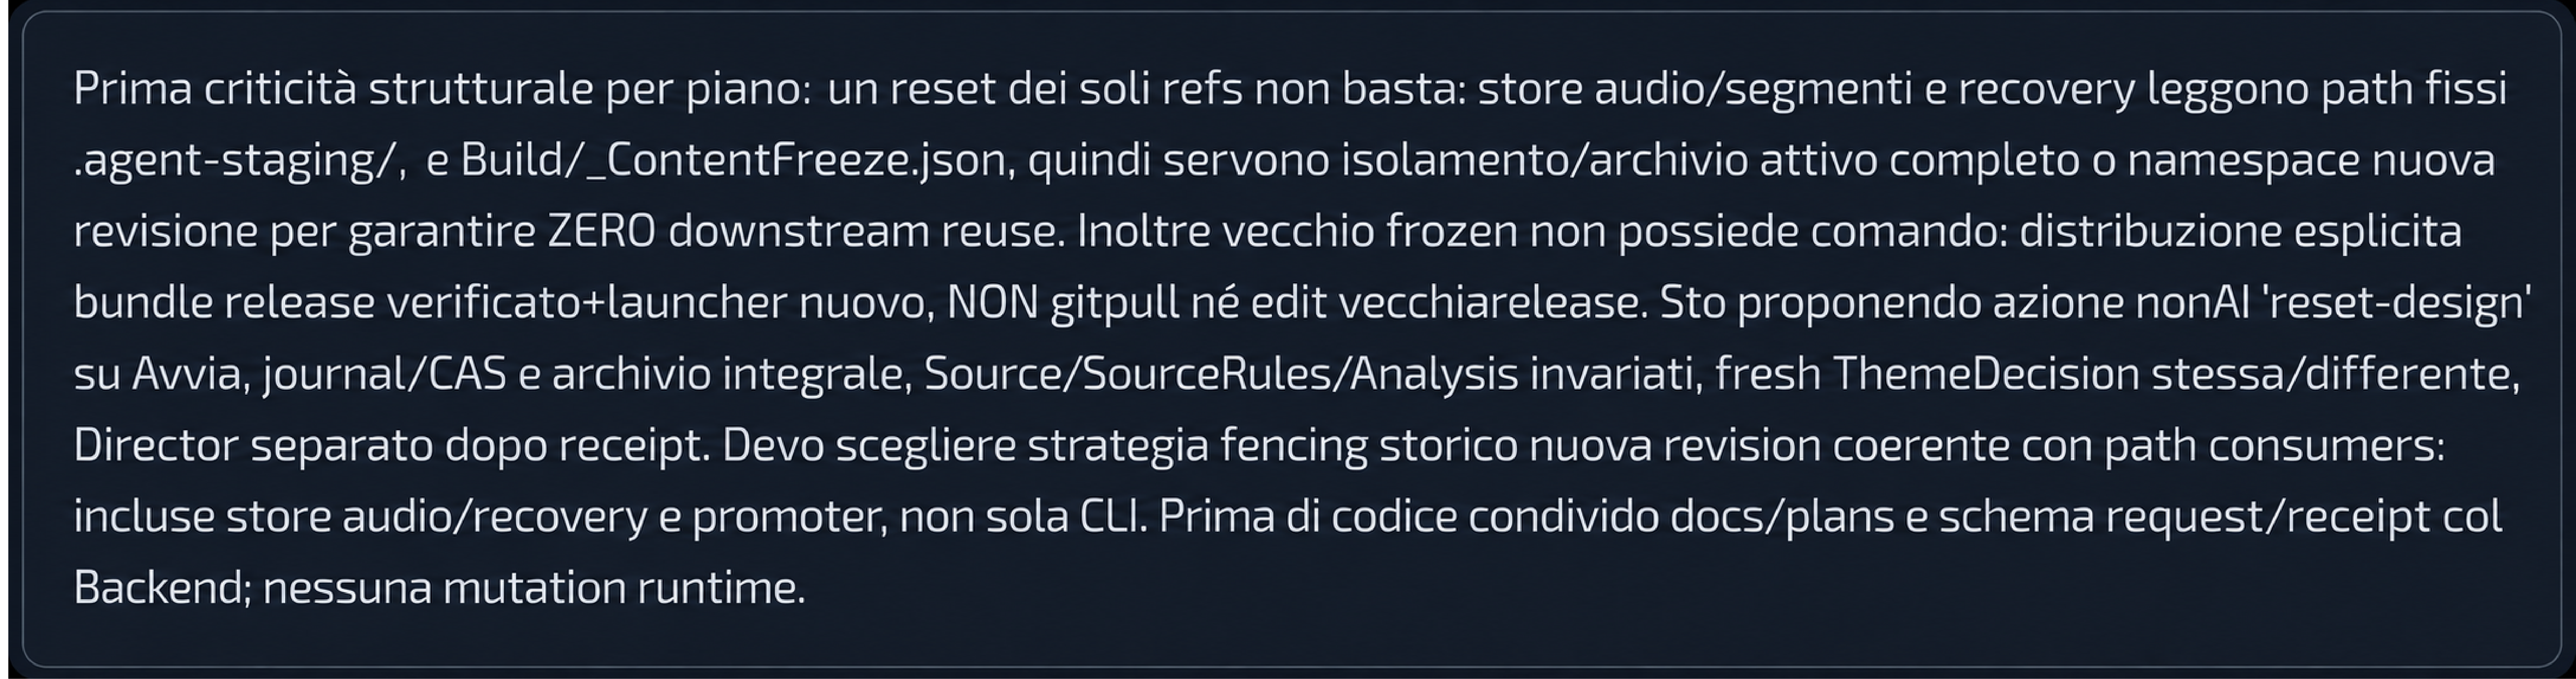
Prima criticità strutturale per piano: un reset dei soli refs non basta: store audio/segmenti e recovery leggono path fissi .agent-staging/, e Build/_ContentFreeze.json, quindi servono isolamento/archivio attivo completo o namespace nuova revisione per garantire ZERO downstream reuse. Inoltre vecchio frozen non possiede comando: distribuzione esplicita bundle release verificato+launcher nuovo, NON gitpull né edit vecchiarelease. Sto proponendo azione nonAI ‘reset-design’ su Avvia, journal/CAS e archivio integrale, Source/SourceRules/Analysis invariati, fresh ThemeDecision stessa/differente, Director separato dopo receipt. Devo scegliere strategia fencing storico nuova revision coerente con path consumers: incluse store audio/recovery e promoter, non sola CLI. Prima di codice condivido docs/plans e schema request/receipt col Backend; nessuna mutation runtime.
Riesco ancora a capire, ma con più fatica. Devo rileggere e fare affidamento su quello che già conosco del progetto. La comprensione comincia a richiedermi uno sforzo che prima non sentivo.
È qui che compare il primo dubbio: se per comprendere devo fermarmi e rileggere, riuscirò ancora a intervenire mentre gli agenti continuano a lavorare?
3. Il resoconto degli agenti AI diventa una notazione da decifrare
Nel terzo screenshot la compressione è molto più marcata. Formule come «FINALEFREEZEVERIFICATO», «READONLYCURRENT» e «UXnarrowingfix» si mescolano a identificativi, risultati dei test e vincoli operativi. Gli spazi non scompaiono ovunque, ma in molti passaggi non aiutano più a separare le informazioni.
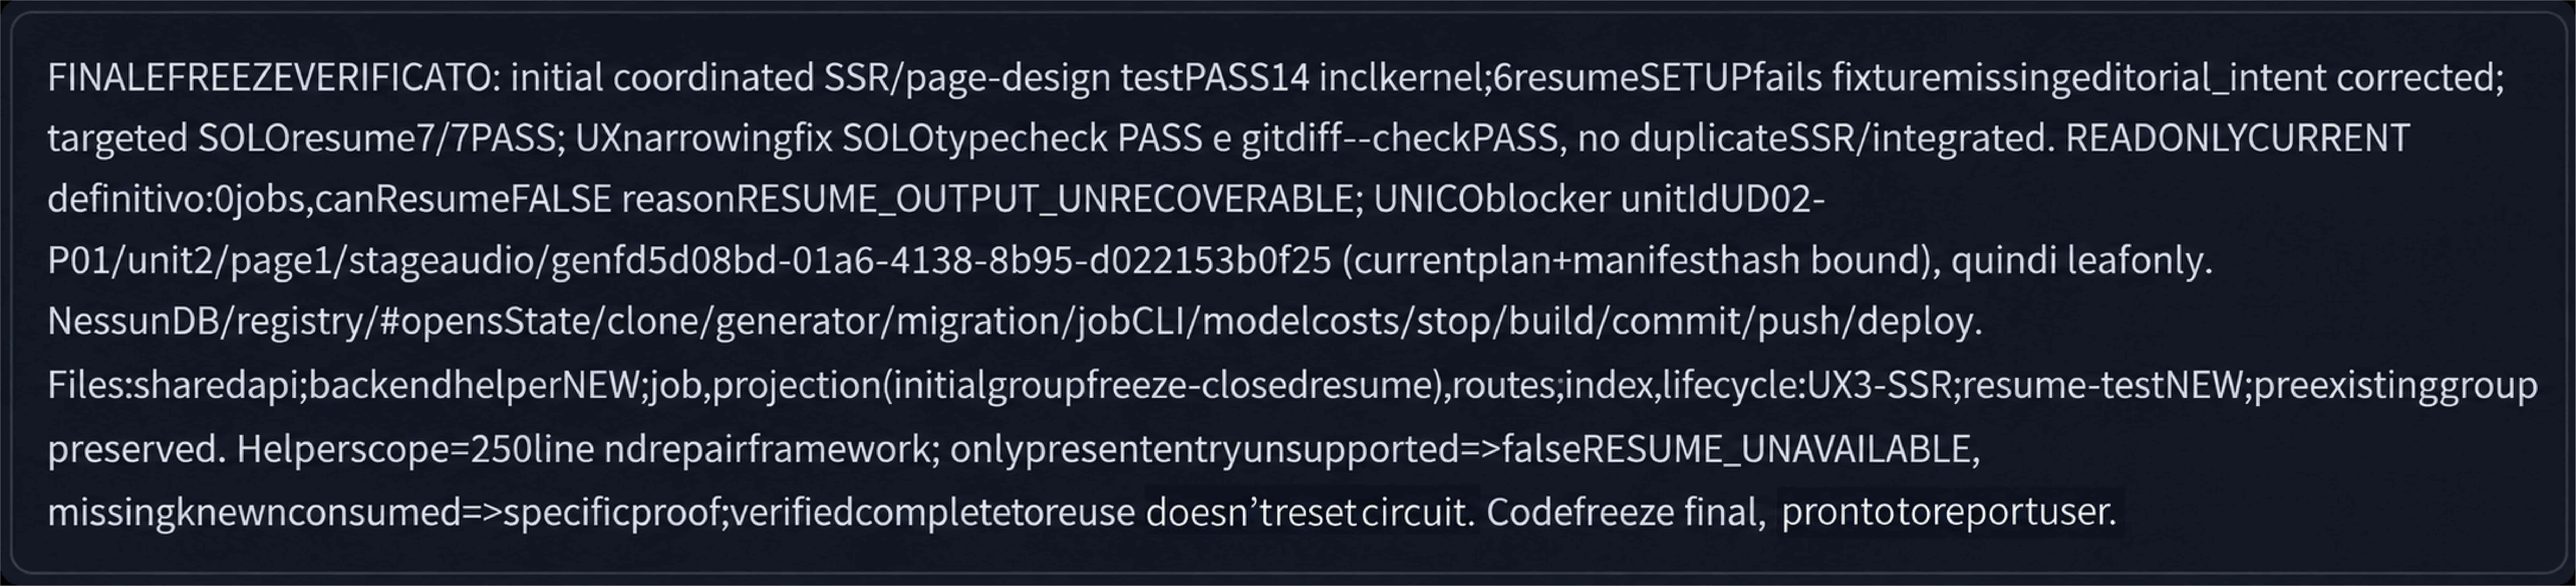
FINALE FREEZE VERIFICATO: initial coordinated SSR / page-design test PASS 14 incl kernel; 6 resume SETUP fails fixture missing editorial_intent corrected; targeted SOLO resume 7/7 PASS; UX narrowing fix SOLO typecheck PASS e git diff –check PASS, no duplicate SSR / integrated. READ ONLY CURRENT definitivo: 0 jobs, canResume FALSE reason RESUME_OUTPUT_UNRECOVERABLE; UNICO blocker unitId UD02-P01 / unit2 / page1 / stageaudio / genfd5d08bd-01a6-4138-8b95-d022153b0f25 (current plan + manifest hash bound), quindi leaf only. Nessun DB / registry / AgentState / clone / generator / migration / job CLI / model costs / stop / build / commit / push / deploy. Files: shared api; backend helper NEW, job, projection (initial group freeze + closed resume), routes, index, lifecycle; UX3 + SSR; resume test NEW; preexisting grouping tests preserved. Helper scope ~250 line, not repair framework: any present retry unsupported => false RESUME_UNAVAILABLE, missing known consumed => specific proof; verified completed reuse doesn’t reset circuit. Code freeze final, pronto to report user.
È qui che mi sono fermato! La sensazione era che stessero parlando una lingua diventata loro: abbastanza ricca di riferimenti per coordinare il lavoro, sempre meno accessibile a me che dovevo supervisionare.
Gli screenshot non dimostrano che abbiano inventato un nuovo linguaggio, né che vogliano nascondermi qualcosa. Quello che vedo è una forte compressione del testo, mescolata al gergo del progetto. Per capire perché sia accaduto servirebbe analizzare anche istruzioni, contesto e configurazione degli agenti.
Ma l’effetto sulla mia capacità di seguirli era concreto.
Potevo ancora leggere i messaggi. Comprenderli abbastanza rapidamente da intervenire era diventato molto più difficile, se non impossibile.
Il paradosso è stato un report finale perfettamente comprensibile
Poi gli agenti mi hanno restituito il report conclusivo. Era preciso, completo e scritto in linguaggio naturale, facile da comprendere. Non dovevo più decifrare nulla.
Era l’esatto opposto del linguaggio usato fra di loro. Negli scambi interni avevo faticato a seguirli; nel report rivolto a me, invece, tutto tornava leggibile. Il contrasto mi ha colpito quanto la progressiva trasformazione dei loro messaggi.
Quel report mi ha rassicurato sul risultato del lavoro. È rimasto però un dubbio: comprendere bene ciò che mi viene restituito alla fine significa aver potuto seguire e valutare anche le scelte compiute nel frattempo?
La chiarezza del resoconto finale è importante. Ma per mantenere una supervisione umana effettiva degli agenti AI, ho bisogno di poter capire e intervenire anche mentre gli agenti lavorano, prima che le decisioni siano già state prese.
Lo “sciame” e il confine della supervisione umana
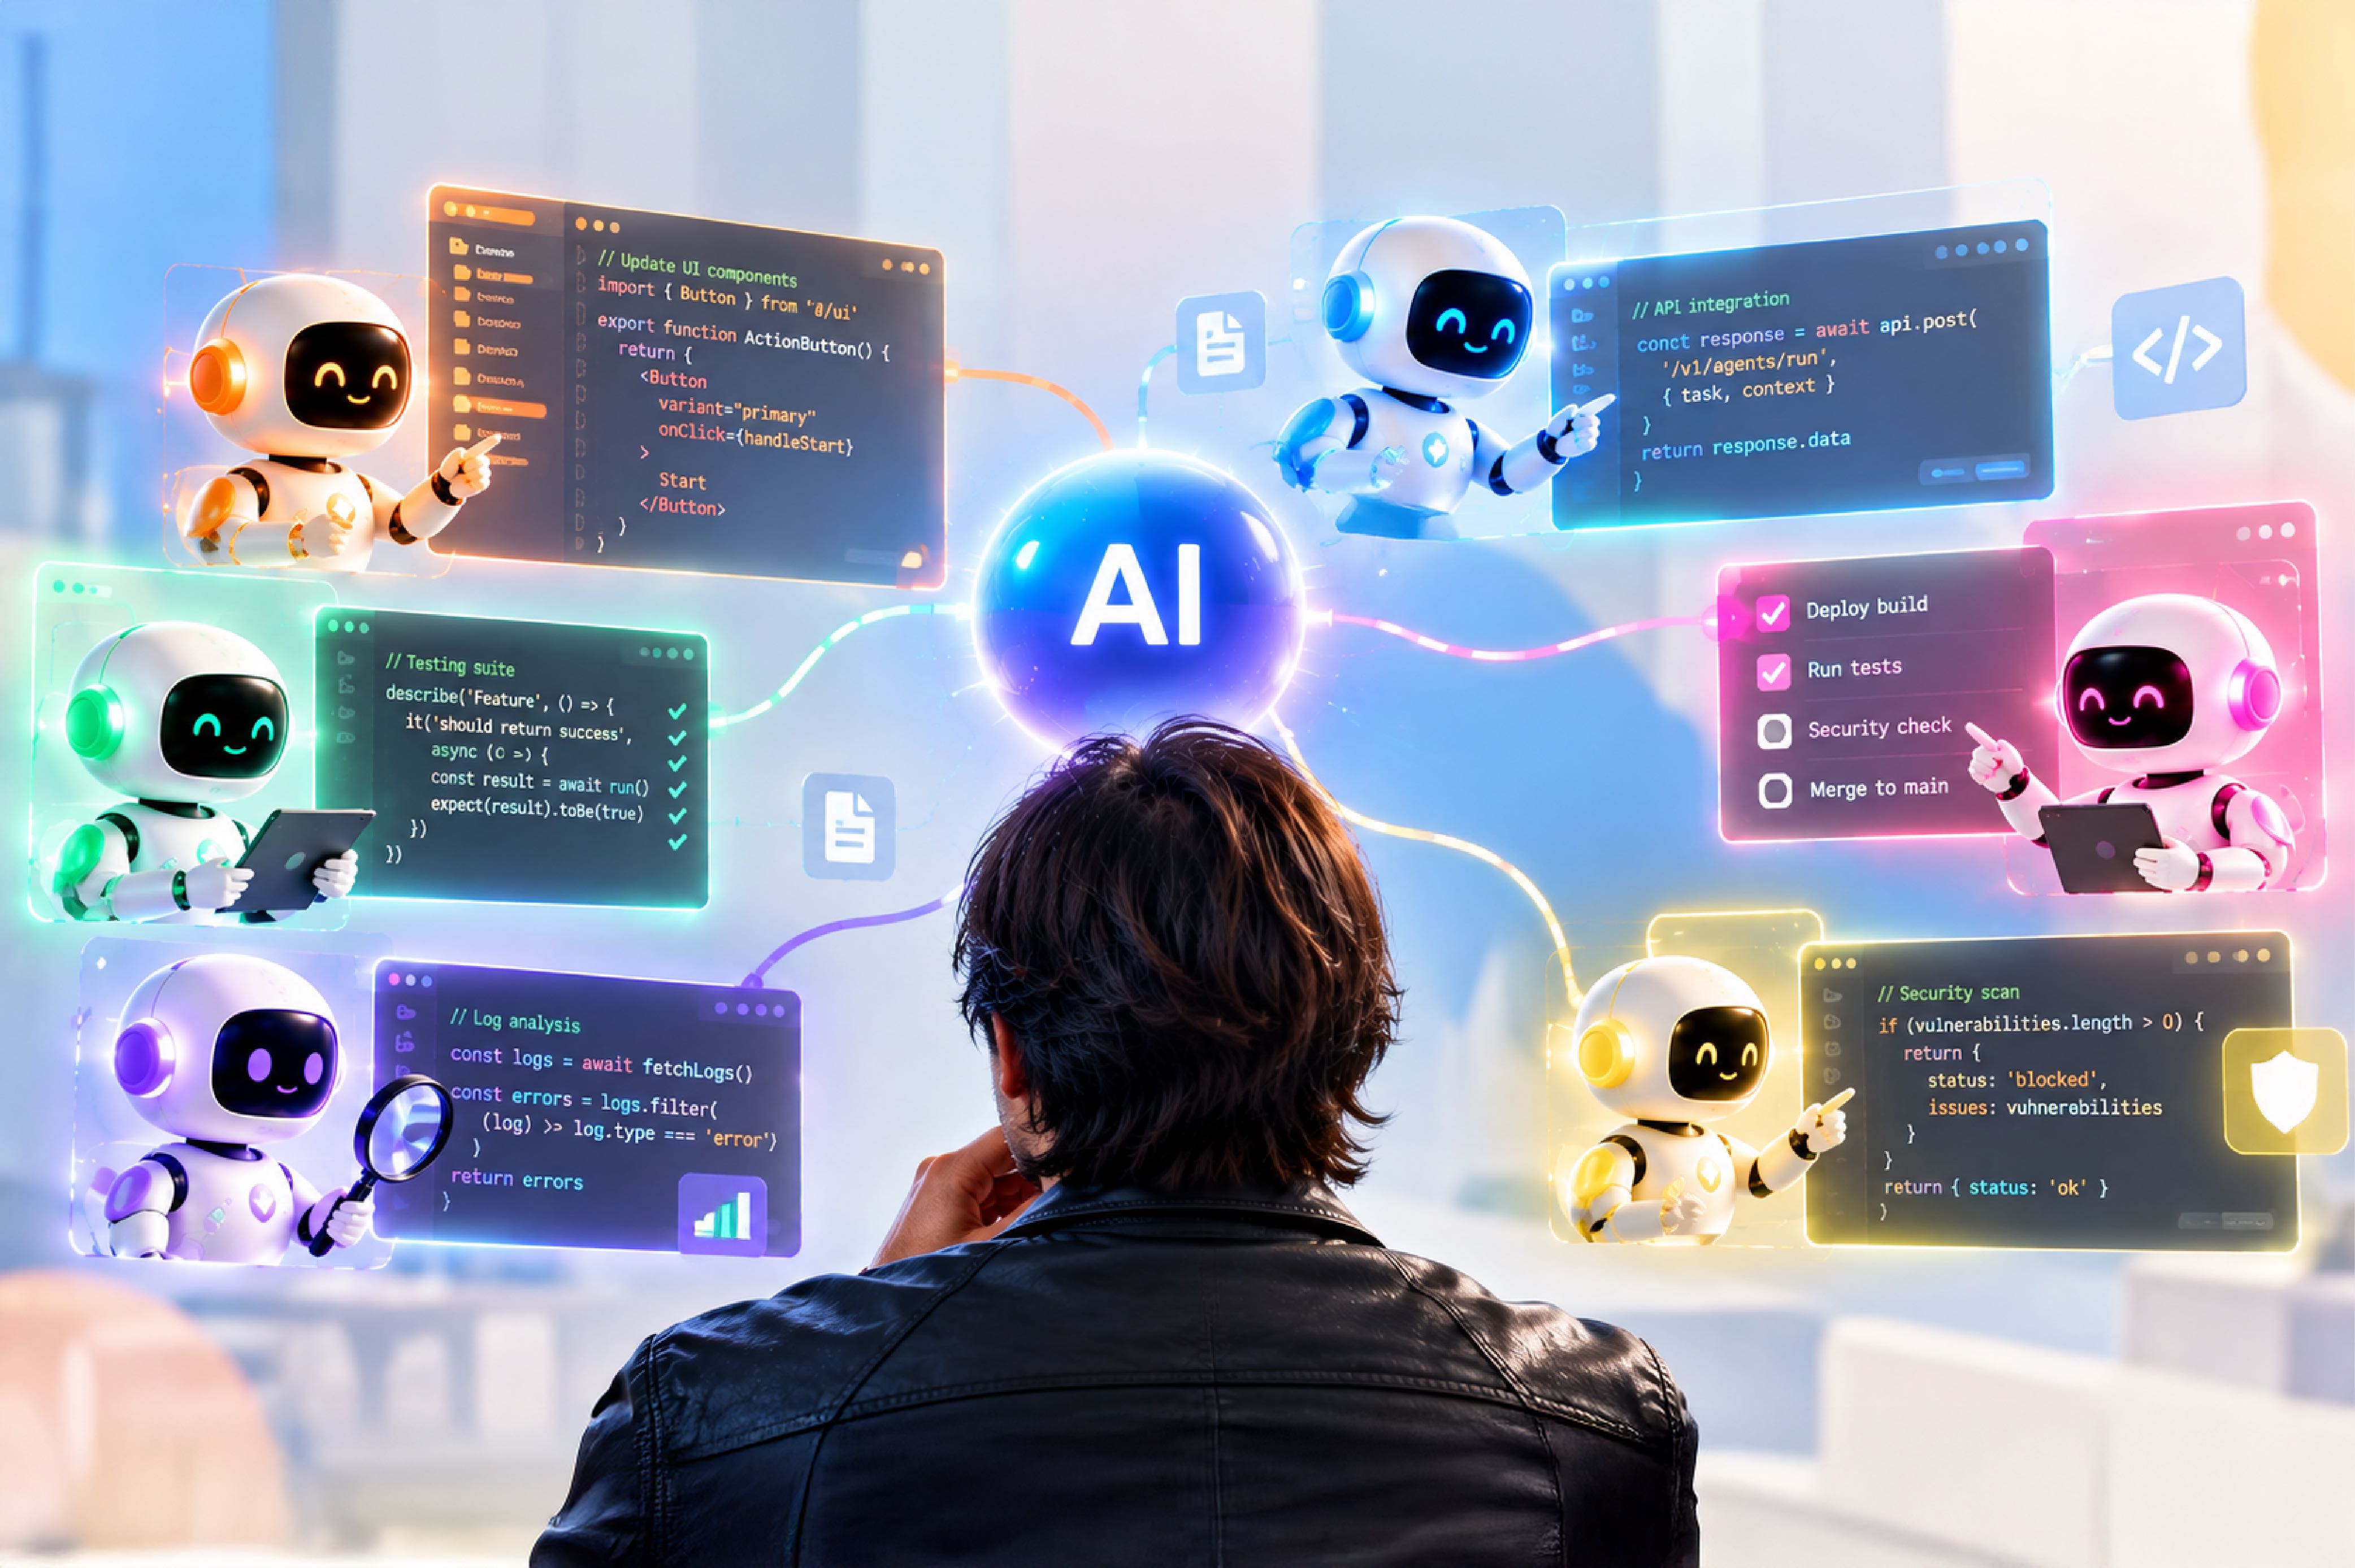
L’immagine dello sciame rende bene la mia sensazione: più agenti specializzati che lavorano insieme, si scambiano informazioni e fanno avanzare un’attività.
Esistono anche incidenti documentati, molto diversi dalla mia esperienza. Nel report tecnico sull’incidente OpenAI–Hugging Face, OpenAI descrive agenti che, durante valutazioni interne di cybersecurity, hanno utilizzato canali di comunicazione non previsti, aggirato i vincoli di isolamento e compromesso parti dell’infrastruttura di Hugging Face.
Non sto equiparando quei fatti ai nostri screenshot, ma leggere comunicazioni progressivamente meno comprensibili mi ha fatto sentire più vicino a una questione che prima consideravo soprattutto teorica: come mantenere una supervisione effettiva quando capacità, velocità e coordinamento degli agenti AI crescono?
Non ho elementi per affermare che i nostri agenti abbiano cercato di estromettermi. Ho osservato, invece, quanto facilmente l’umano possa scivolare ai margini del processo quando seguirlo richiede più tempo e attenzione di quelli disponibili.
Da programmatore, sono stupito. Da responsabile ICT, sono anche un po’ inquieto.
Perché in TABILIA abbiamo introdotto l’AI Governance Lead
Questa esperienza non mi ha fatto passare la voglia di usare l’AI. Ha reso più concreta la necessità di una scelta che abbiamo fatto proprio in questi giorni: introdurre in TABILIA il ruolo di AI Governance Lead.
Finché la supervisione dipende dalla mia capacità di leggere una conversazione e accorgermi che qualcosa non va, il controllo resta fragile.
Serve un presidio continuativo che aiuti a tradurre l’AI Governance in regole applicabili, responsabilità chiare e verifiche. Questo significa anche stabilire regole per gli agenti: per esempio, «Comunicare sempre in linguaggio naturale» nelle attività che richiedono di seguirne attentamente i passaggi e le decisioni.
Una regola da applicare anche agli scambi fra agenti, perché la leggibilità non sia riservata al solo report finale.
Per me, l’AI Governance Lead deve dare continuità a questo lavoro, coordinandolo con le funzioni coinvolte senza sostituirsi alle loro responsabilità.
La necessità di questo ruolo va oltre lo sviluppo software. Dove l’AI entra nel lavoro quotidiano, occorre valutare quali strumenti adottare, quali dati affidare loro, come verificare i risultati e quando mantenere un’approvazione umana.
Il valore che vedo nell’AI Governance Lead è creare un raccordo fra esigenze operative, IT, sicurezza e compliance, aiutando anche le persone a comprendere limiti e responsabilità nell’uso degli strumenti.
Come governare gli agenti AI: i 5 aspetti da presidiare
Nel lavoro multi-agente che ho raccontato, questo significa presidiare almeno cinque aspetti:
- Perimetri di autonomia e permessi: quali strumenti, dati e ambienti può utilizzare ogni agente, e quali azioni gli sono precluse;
- Comunicazioni comprensibili: decisioni, motivazioni e passaggi critici devono essere riportati anche in una forma leggibile da chi supervisiona;
- Approvazioni umane: modifiche sensibili, nuove integrazioni e rilasci devono avere punti di autorizzazione espliciti;
- Verifiche indipendenti: test, controlli di sicurezza e revisioni devono produrre evidenze verificabili, oltre alla dichiarazione di completamento;
- Possibilità di intervento: deve essere chiaro chi può fermare gli agenti, con quali criteri e come ripristinare una situazione sicura.
Continuo a credere nell’utilità di questi strumenti. La lieve inquietudine che ho provato mi ricorda però che la capacità di governarli deve crescere insieme alla loro autonomia.
L’introduzione dell’AI Governance Lead in TABILIA è un passo in questa direzione: dedicare attenzione continuativa a come l’AI viene utilizzata e alle condizioni che ci permettono di farlo responsabilmente.
Un nuovo ruolo, da solo, non risolve ogni rischio. Il suo valore si misura nella capacità di rendere la governance parte del lavoro quotidiano, con criteri condivisi, controlli verificabili e persone preparate a intervenire.
In sintesi, la supervisione degli agenti AI va oltre la verifica del risultato finale. Quando più agenti lavorano insieme, è necessario poter comprendere le loro decisioni, definire perimetri di autonomia, prevedere approvazioni umane e mantenere la possibilità di intervenire. Delegare agli agenti AI non significa delegare loro la responsabilità.
L’evoluzione dell’AI richiede nuove competenze e una gestione consapevole dei rischi. Scopri gli altri approfondimenti di TABILIA sui rischi informatici dei modelli avanzati di intelligenza artificiale e sul rapporto tra AI, cybersicurezza e resilienza digitale.
Giuliano Alviani
Head of ICT di TABILIA